El uso de datos sintéticos de entrenamiento IA ofrece una respuesta clara ante el dilema de como alimentar modelos analíticos avanzados sin afectar el derecho a la privacidad de los individuos. Históricamente, la precisión de un modelo informático dependía de la recolección directa de registros de clientes reales, pero al entrar en vigencia las normas internacionales estrictas ha convertido esto en un riesgo operativo evidente.
Además de resolver las barreras éticas y regulatorias, la creación de información artificial permite abordar deficiencias históricas en los conjuntos de datos tradicionales, como la falta de ejemplos sobre eventos poco comunes o la presencia de sesgos discriminatorios. Al controlar los parámetros de generación de datos, los equipos desarrolladores pueden simular escenarios complejos y balancear las muestras de entrenamiento con precisión matemática.
Datos sintéticos para IA representan una alternativa tecnológica para desarrollar, probar y entrenar sistemas de inteligencia artificial sin depender exclusivamente de información real de clientes. A través de algoritmos capaces de reproducir patrones estadísticos, relaciones entre variables y características relevantes de conjuntos de datos originales, las organizaciones pueden crear información artificial útil para numerosas aplicaciones. Comprender qué son los datos sintéticos, cómo se generan y cuáles son sus límites resulta especialmente importante para las empresas que necesitan aprovechar sus datos sin exponer información confidencial ni comprometer la privacidad de las personas.
Datos sintéticos para IA
Los datos sintéticos para IA son conjuntos de información generados artificialmente mediante algoritmos, modelos estadísticos, simulaciones o técnicas de aprendizaje automático. Su propósito consiste en representar determinadas características de datos reales sin utilizar necesariamente sus registros originales durante el entrenamiento o las pruebas de otros sistemas.
En una empresa, los datos pueden incluir historiales de compra, transacciones bancarias, comportamientos de navegación, solicitudes de atención al cliente o registros de inventario. Muchos de estos conjuntos contienen información personal, comercialmente sensible o protegida por obligaciones contractuales.
La generación de información sintética permite construir escenarios similares a los que aparecen en las operaciones habituales, pero utilizando registros creados para una finalidad específica.
Por ejemplo, una compañía de comercio electrónico puede necesitar entrenar un algoritmo que prediga la demanda de productos. En lugar de proporcionar directamente todos los historiales individuales de sus compradores, puede generar registros artificiales que representen tendencias de compra, diferencias estacionales y relaciones entre categorías de productos.
El objetivo no consiste en copiar las operaciones de cada persona, sino en conservar las propiedades relevantes para el problema que debe resolver el modelo.
Sin embargo, existe una distinción fundamental: que un dato sea sintético no significa automáticamente que sea anónimo o imposible de relacionar con una persona real. Si el generador memoriza registros o reproduce combinaciones muy particulares, todavía pueden aparecer riesgos de divulgación.
¿Qué es un dato sintético?
Un dato sintético es un registro creado artificialmente que responde a determinadas reglas, distribuciones estadísticas o patrones aprendidos.
Imaginemos una tienda que registra compras con información sobre edad, importe, categoría de producto y método de pago.
Un registro real podría corresponder a una operación efectuada por un comprador concreto. En cambio, un registro sintético representaría una operación ficticia construida para mantener una estructura coherente con las características que se desean estudiar.
Por ejemplo:
| Característica |
Registro real |
Registro sintético |
| Cliente |
Persona que realizó una compra |
Perfil ficticio generado |
| Edad |
Edad declarada por el comprador |
Edad artificial plausible |
| Importe |
Valor efectivamente pagado |
Valor producido mediante un modelo |
| Producto |
Artículo realmente adquirido |
Categoría generada |
| Finalidad |
Registrar una operación |
Probar o entrenar un sistema |
Este ejemplo es ilustrativo y no utiliza registros de clientes reales.
La diferencia más importante está en el origen del registro y en la relación que mantiene con personas o acontecimientos concretos.
Mientras que un dato real documenta algo que sucedió, uno sintético representa una posibilidad construida mediante un procedimiento técnico.
¿Qué son los datos sintéticos en IA?
La búsqueda que son datos sinteticos en ia está relacionada con una necesidad creciente: disponer de información suficiente para entrenar algoritmos sin aumentar innecesariamente la exposición de datos sensibles.
Los sistemas de aprendizaje automático necesitan ejemplos para identificar patrones. Sin embargo, obtener datos adecuados puede resultar complicado por motivos de privacidad, costes, escasez de observaciones o dificultades para representar situaciones poco frecuentes.
Los datos sintéticos permiten abordar algunos de estos problemas.
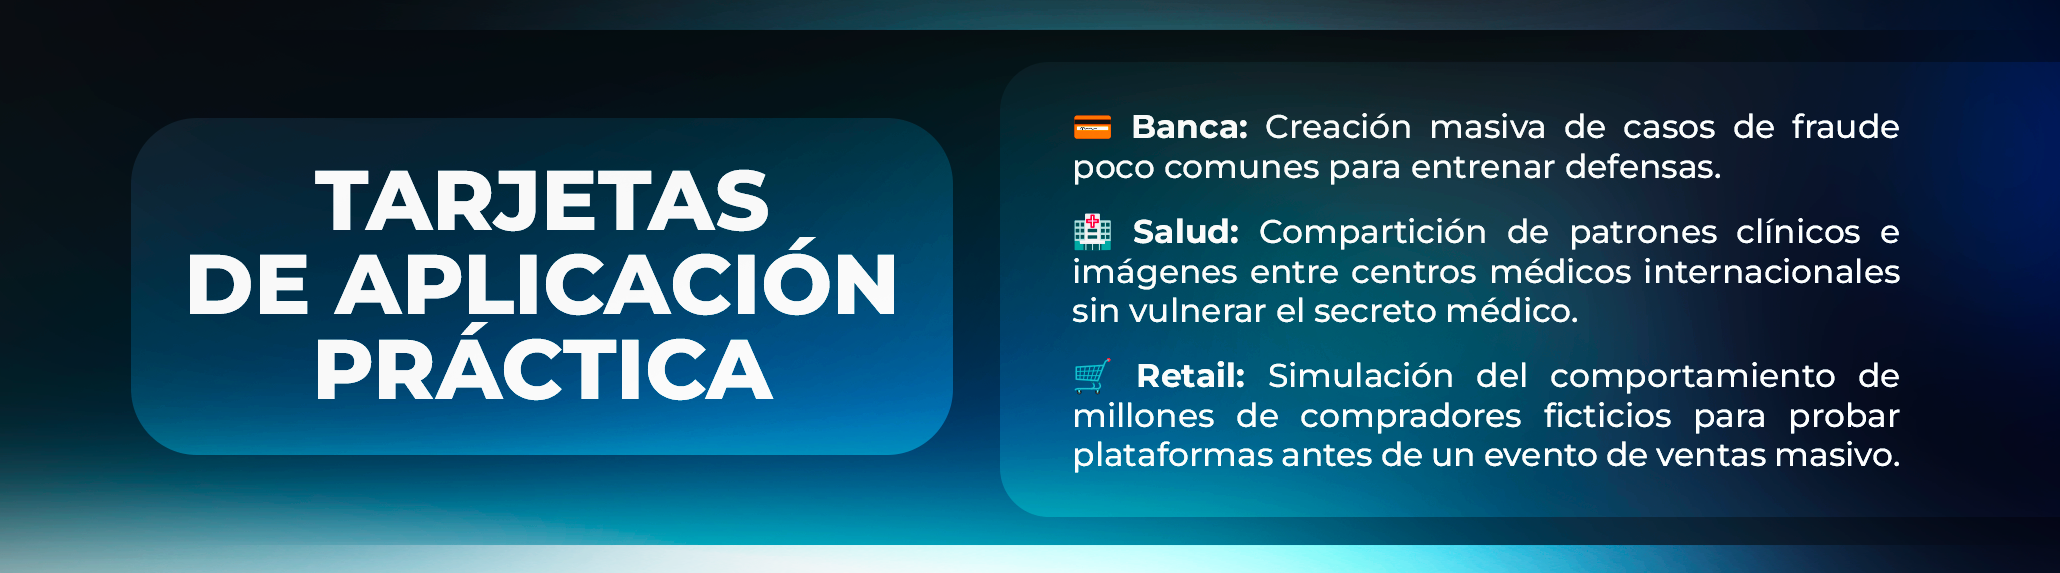
Una entidad financiera, por ejemplo, puede disponer de millones de operaciones legítimas y relativamente pocos casos confirmados de fraude. Esta diferencia dificulta que determinados algoritmos aprendan a reconocer comportamientos fraudulentos.
Mediante simulaciones y generación controlada pueden construirse situaciones artificiales que representen distintos mecanismos de fraude, siempre que estas reproducciones sean técnicamente razonables.
También pueden utilizarse para verificar cómo responde un sistema cuando recibe información incompleta, valores fuera de rango o combinaciones poco habituales.
Entre sus aplicaciones destacan:
-
Entrenamiento de algoritmos predictivos.
-
Pruebas de software y bases de datos.
-
Simulación de operaciones comerciales.
-
Desarrollo de sistemas de detección de anomalías.
-
Evaluación de modelos antes de su implementación.
-
Creación de escenarios difíciles de observar.
-
Formación técnica y demostraciones de productos digitales.
Una ventaja relevante es la posibilidad de controlar las características de los ejemplos generados.
Si una empresa necesita comprobar el funcionamiento de una aplicación con miles de usuarios simultáneos, puede construir perfiles y transacciones artificiales sin utilizar directamente las cuentas de sus clientes.
No obstante, la utilidad de estos datos depende de su calidad. Un conjunto artificial con relaciones incorrectas puede provocar que el modelo aprenda comportamientos que no se presentan en situaciones reales.
Cómo entrenar algoritmos sin comprometer información real de clientes
Cómo entrenar algoritmos sin comprometer información real de clientes es una cuestión central para las organizaciones que desarrollan inteligencia artificial en sectores como banca, comercio electrónico, seguros y atención sanitaria.
El procedimiento requiere una combinación de técnicas de protección de datos, diseño de modelos y evaluación de riesgos.
La primera decisión consiste en determinar qué información necesita realmente el algoritmo.
Si el objetivo es predecir la demanda semanal de una tienda, quizá sea suficiente utilizar cantidades vendidas por categoría, tendencias estacionales y periodos de promoción.
En ese caso, podrían evitarse por completo nombres, direcciones, números de teléfono y otros identificadores personales.
Cuando es necesario reproducir relaciones estadísticas complejas, las organizaciones pueden entrenar un generador dentro de un entorno restringido y utilizar posteriormente los registros artificiales para desarrollar otro modelo.
Un proceso responsable suele incluir las siguientes actividades:
Definir el objetivo del sistema y justificar qué variables son necesarias.
Examinar los datos originales e identificar información personal o confidencial.
Aplicar medidas de minimización y control de acceso.
Seleccionar una técnica de generación adecuada.
Crear un conjunto sintético separado de los registros originales.
Evaluar su utilidad estadística y sus riesgos de privacidad.
Entrenar el algoritmo con los datos aprobados.
Validar el rendimiento mediante pruebas independientes y autorizadas.
La separación de entornos es particularmente importante.
Los datos reales pueden permanecer bajo controles estrictos, mientras que los conjuntos sintéticos que superen las evaluaciones correspondientes pueden utilizarse en actividades de desarrollo con un acceso adaptado al riesgo residual.
Los registros originales tampoco deben enviarse automáticamente a servicios externos de generación sin comprobar las condiciones de tratamiento, seguridad y confidencialidad.
Datos sintéticos definición
La expresión datos sintéticos definicion describe la información artificial producida mediante procedimientos capaces de representar determinadas propiedades de datos observados o de escenarios diseñados.
No todos los datos sintéticos se crean de la misma manera.
Algunos se generan a partir de reglas predefinidas. Otros proceden de modelos entrenados sobre conjuntos de información real. También existen simulaciones que representan procesos físicos, comerciales o sociales sin necesitar registros individuales de clientes.
Sus características principales pueden resumirse en cuatro dimensiones.
Coherencia estructural. Los registros deben respetar el formato esperado por los sistemas que los utilizarán. Una base de datos de ventas, por ejemplo, necesita campos compatibles con fechas, importes y categorías.
Realismo estadístico. Cuando el objetivo consiste en representar una población, conviene conservar patrones relevantes, como distribuciones de valores y relaciones entre variables.
Utilidad funcional. Los datos deben servir para resolver la tarea prevista. Un conjunto que parece realista puede no ser adecuado para entrenar un detector de fraude.
Protección de información sensible. Es necesario comprobar que la generación no exponga registros individuales ni permita inferir información protegida con un riesgo inaceptable.
Estas propiedades deben evaluarse de forma independiente, porque aumentar el realismo no garantiza mejorar la privacidad.
Generación de datos sintéticos
La generación de datos sintéticos puede realizarse mediante enfoques diferentes según el volumen de información disponible, el tipo de datos y la finalidad del proyecto.
No existe un método que funcione mejor en todos los escenarios.
| Técnica |
Funcionamiento |
Aplicación habitual |
| Generación basada en reglas |
Produce registros conforme a condiciones definidas |
Pruebas de aplicaciones y formularios |
| Métodos estadísticos |
Utiliza distribuciones y relaciones probabilísticas |
Simulación de datos tabulares |
| Redes generativas adversarias |
Entrena modelos generadores y discriminadores |
Imágenes y determinados datos estructurados |
| Modelos variacionales |
Aprenden representaciones probabilísticas |
Generación de registros y señales |
| Modelos de difusión |
Generan ejemplos mediante procesos de eliminación de ruido |
Imágenes y otros datos complejos |
| Simulaciones |
Reproducen procesos mediante modelos matemáticos |
Robótica, industria y transporte |
La elección depende de cuánto control necesita el equipo sobre los resultados.
Los métodos basados en reglas pueden resultar suficientes para comprobar un formulario de registro o probar los límites de una aplicación.
En cambio, reproducir interacciones complejas entre cientos de variables puede requerir modelos estadísticos o técnicas avanzadas de aprendizaje automático.
También debe considerarse el coste computacional, la facilidad de auditoría y el volumen de datos originales necesario para entrenar el generador.
Datos sintéticos ejemplos
Los datos sintéticos ejemplos ayudan a comprender cómo se utiliza esta tecnología fuera de los entornos de investigación.
Uno de los casos más sencillos aparece en las pruebas de plataformas comerciales.
Una empresa puede crear miles de clientes ficticios, pedidos, devoluciones y movimientos de inventario para comprobar su sistema antes de utilizarlo con usuarios reales.
En el sector bancario, pueden construirse operaciones simuladas con distintos importes, horarios, ubicaciones y patrones de comportamiento para evaluar herramientas de detección de anomalías.
En el ámbito sanitario, se pueden generar historiales artificiales que representen relaciones entre variables clínicas. Sin embargo, estos conjuntos requieren una evaluación particularmente cuidadosa, porque las relaciones médicas incorrectas pueden comprometer la validez de los resultados.
En la industria automotriz, los simuladores permiten crear imágenes y secuencias de conducción con diferentes condiciones meteorológicas, obstáculos y situaciones de tráfico.
Esto facilita probar sistemas de percepción en escenarios que serían costosos o peligrosos de reproducir constantemente en carreteras reales.
También existen aplicaciones en educación, donde los conjuntos ficticios permiten enseñar análisis de datos sin proporcionar al alumnado información confidencial de clientes.
En todos estos casos, el valor se encuentra en disponer de ejemplos relevantes para una tarea claramente definida.
¿Qué tipo de datos preserva la generación de datos sintéticos?
La pregunta qué tipo de datos preserva la generación de datos sintéticos requiere distinguir entre conservar propiedades de la información y mantener registros individuales.
Un generador puede diseñarse para reproducir ciertas características estadísticas sin replicar las observaciones originales.
Entre las propiedades que puede intentar conservar se encuentran:
-
Distribuciones estadísticas: proporción de valores presentes en diferentes categorías.
-
Medidas agregadas: medias, medianas, dispersiones y frecuencias.
-
Correlaciones: relaciones estadísticas entre determinadas variables.
-
Dependencias temporales: patrones de evolución cuando se trabaja con series cronológicas.
-
Estructuras de datos: nombres de campos, tipos de variables y relaciones entre tablas.
-
Patrones de comportamiento: tendencias generales identificadas en una población.
Por ejemplo, si una tienda observa que las compras de ciertos productos aumentan durante determinadas temporadas, un conjunto sintético puede intentar reproducir esa relación.
Sin embargo, preservar una correlación no significa conservar todas las relaciones importantes.
Un modelo puede representar correctamente el promedio de gasto y fallar al reproducir el comportamiento de compradores poco frecuentes.
También puede distorsionar grupos minoritarios o situaciones extremas.
Por ese motivo, es necesario establecer previamente qué propiedades son esenciales para la tarea y comprobar después si realmente se conservaron.
Diferencias entre datos sintéticos, datos anonimizados y datos seudonimizados
Estos conceptos suelen confundirse, aunque representan procedimientos diferentes.
Los datos anonimizados son aquellos que, tras un tratamiento adecuado y considerando los medios razonablemente disponibles, ya no permiten identificar a las personas.
Los datos seudonimizados sustituyen o separan ciertos identificadores, pero pueden continuar relacionándose con individuos mediante información adicional. Por tanto, siguen siendo datos personales cuando existe posibilidad de identificación.
Los datos sintéticos son registros generados artificialmente. Su clasificación en materia de privacidad depende de cómo fueron producidos y de si pueden vincularse con personas identificadas o identificables.
| Característica |
Sintéticos |
Anonimizados |
Seudonimizados |
| Origen |
Generación artificial |
Datos reales transformados |
Datos reales modificados |
| Conservación de registros originales |
No necesariamente |
Pueden conservar atributos transformados |
Conservan información vinculable |
| Riesgo de identificación |
Depende del método |
Debe reducirse hasta alcanzar anonimato efectivo |
Sigue existiendo |
| Uso habitual |
Entrenamiento y pruebas |
Análisis y difusión controlada |
Tratamiento con protección adicional |
Esta distinción importa especialmente cuando una organización pretende compartir información con terceros.
El hecho de sustituir nombres por códigos ficticios no convierte automáticamente una base de datos en sintética ni anónima.
Del mismo modo, generar registros mediante inteligencia artificial tampoco garantiza que desaparezcan los riesgos de identificación.
Riesgos de privacidad en los datos sintéticos para IA
Uno de los errores más importantes consiste en considerar que todos los datos generados artificialmente pueden compartirse sin restricciones.
Los modelos generativos pueden memorizar fragmentos del conjunto utilizado durante su entrenamiento.
Si determinados registros son muy singulares, un generador podría reproducir información demasiado similar a la original.
También existen ataques que intentan inferir si una persona participó en el conjunto de entrenamiento o recuperar atributos sensibles mediante información auxiliar.
El organismo estadounidense NIST advierte que numerosas técnicas de datos sintéticos carecen de garantías formales de privacidad y pueden presentar vulnerabilidades ante determinados ataques. <Cite ref="turn743025search34"/>
Para reducir los riesgos, las empresas pueden aplicar medidas como:
-
Limitar el acceso a los conjuntos originales.
-
Evitar la incorporación de identificadores innecesarios.
-
Detectar registros sintéticos excesivamente similares a observaciones reales.
-
Evaluar riesgos de reidentificación e inferencia.
-
Aplicar mecanismos de privacidad diferencial cuando corresponda.
-
Documentar el origen y las transformaciones de los datos.
-
Restringir la distribución de conjuntos que no hayan superado las verificaciones.
Una evaluación de privacidad debe considerar tanto los datos publicados como el modelo generador y los sistemas que intervienen en el proceso.
La protección efectiva requiere controles técnicos y organizativos, no solamente un procedimiento de generación.
Privacidad diferencial y generación segura de información artificial
La privacidad diferencial es un marco matemático que permite cuantificar determinados riesgos asociados a la participación de una persona en un conjunto de datos.
Su principio consiste en limitar cuánto puede cambiar el resultado de un procedimiento cuando se incorpora o elimina la información de un individuo, según la definición de registros y las garantías utilizadas.
Puede aplicarse a determinados mecanismos de generación de datos sintéticos.
Una ventaja de este enfoque es que permite formular garantías de privacidad más precisas que una simple afirmación de que los registros son artificiales.
Sin embargo, su implementación requiere decisiones técnicas importantes.
El presupuesto de privacidad, la composición de múltiples operaciones y la sensibilidad de las consultas pueden afectar las garantías finales.
Además, existe una relación entre privacidad y utilidad: introducir mayores niveles de protección puede reducir la precisión de determinadas propiedades estadísticas.
Por eso, un sistema debe evaluarse según el riesgo permitido y la utilidad necesaria.
El NIST explica que los conjuntos sintéticos generados mediante mecanismos diferencialmente privados pueden conservar estructuras y propiedades útiles mientras ofrecen garantías matemáticas definidas. <Cite ref="turn743025search6"/>
Esto no significa que toda técnica anunciada como privada ofrezca el mismo nivel de protección.
Cómo evaluar la calidad de un conjunto de datos sintéticos
La calidad no debe medirse únicamente observando si los registros artificiales parecen creíbles.
Un conjunto puede contener nombres ficticios, fechas razonables e importes coherentes y, aun así, resultar inútil para entrenar un algoritmo.
Para evaluar su calidad conviene distinguir tres aspectos.
Fidelidad estadística: compara las características del conjunto sintético con las de la distribución de referencia.
Utilidad predictiva: examina el rendimiento de un algoritmo entrenado con datos sintéticos cuando se aplica a ejemplos reales de evaluación autorizados.
Riesgo de privacidad: analiza la posibilidad de que la información artificial permita recuperar o inferir datos sensibles.
Una práctica útil consiste en entrenar dos modelos equivalentes.
El primero utiliza información real dentro de un entorno autorizado. El segundo emplea el conjunto sintético.
Después, ambos se evalúan mediante datos de prueba independientes que no hayan participado en la generación.
Si el modelo sintético obtiene resultados considerablemente inferiores, será necesario investigar qué propiedades se han perdido.
También conviene medir el rendimiento por segmentos relevantes, porque una buena precisión global puede ocultar errores importantes en grupos poco representados.
Ejemplo práctico: creación de datos sintéticos para una tienda digital
Imaginemos una empresa que desea desarrollar un algoritmo para estimar qué pedidos tienen mayor probabilidad de devolución.
La compañía dispone de información sobre categorías de productos, precios, tiempos de entrega y devoluciones anteriores.
Sin embargo, no quiere proporcionar los registros individuales de sus clientes al equipo externo encargado de probar el sistema.
Una alternativa consiste en generar una base de datos artificial que represente determinadas relaciones entre esas variables.
El proceso podría comenzar con una revisión de los registros originales para identificar atributos innecesarios.
Después se estudiarían las tasas de devolución por categoría, las distribuciones de precios y las posibles relaciones entre tiempos de entrega y devoluciones.
A partir de esa información, el equipo construiría un generador que produzca pedidos ficticios.
Un ejemplo simplificado podría contener los siguientes registros:
| Pedido ficticio |
Categoría |
Importe |
Entrega |
Devolución |
| S-101 |
Ropa |
48 € |
3 días |
Sí |
| S-102 |
Electrónica |
165 € |
2 días |
No |
| S-103 |
Calzado |
72 € |
6 días |
Sí |
| S-104 |
Hogar |
39 € |
4 días |
No |
Estos registros son completamente ilustrativos y no representan información estadística de una empresa real.
Una vez generado un conjunto suficientemente amplio, se comprobarían las relaciones entre variables, la ausencia de reproducciones indebidas y su utilidad en pruebas predictivas.
El equipo externo podría trabajar con los datos aprobados, mientras que la organización conservaría sus registros originales bajo las restricciones correspondientes.
Antes de utilizar el algoritmo en producción, sería necesario evaluar su comportamiento con información real tratada de manera legítima y segura.
¿Cuándo conviene utilizar datos reales y cuándo datos sintéticos?
La elección depende de la finalidad del proyecto.
Los datos reales resultan esenciales cuando es necesario medir con precisión el comportamiento observado de clientes, operaciones o procesos.
Los datos sintéticos pueden resultar especialmente útiles durante el desarrollo inicial, las pruebas de funcionamiento y la construcción de escenarios poco frecuentes.
En numerosos proyectos, la estrategia más adecuada es combinar ambas fuentes.
| Situación |
Enfoque que puede resultar adecuado |
| Pruebas de formularios |
Datos sintéticos basados en reglas |
| Simulación de miles de transacciones |
Datos artificiales estructurados |
| Evaluación final de precisión |
Datos reales autorizados e independientes |
| Escenarios excepcionales |
Simulaciones sintéticas |
| Estudio del comportamiento real del mercado |
Observaciones reales representativas |
| Formación de equipos técnicos |
Conjuntos ficticios controlados |
No conviene sustituir indiscriminadamente la información real por datos generados.
Por ejemplo, un sistema de diagnóstico médico debe demostrar su rendimiento sobre poblaciones y situaciones clínicas relevantes mediante procedimientos de validación apropiados.
Los ejemplos sintéticos pueden complementar el proceso, pero no reemplazan automáticamente la evidencia necesaria para justificar un uso de alto riesgo.
Sesgos y limitaciones de la generación de datos sintéticos
Los modelos generativos suelen aprender de la información disponible.
Si el conjunto original contiene desequilibrios, errores o patrones discriminatorios, es posible que los registros sintéticos reproduzcan esas características.
Imaginemos un sistema entrenado con información de contratación correspondiente a una organización que históricamente ha ofrecido menos oportunidades a determinados grupos.
Un generador podría reproducir esas diferencias, incluso si los nombres y otros identificadores fueran artificiales.
Por tanto, generar nuevos ejemplos no elimina necesariamente los sesgos existentes.
También puede producirse el problema contrario: una generación excesivamente uniforme puede eliminar diferencias legítimas y reducir la capacidad del modelo para reconocer situaciones minoritarias.
Entre las limitaciones más relevantes se encuentran:
-
Representación insuficiente de eventos raros.
-
Reproducción de errores del conjunto original.
-
Pérdida de relaciones complejas entre variables.
-
Creación de combinaciones imposibles o poco plausibles.
-
Alteración de tendencias temporales.
-
Dificultad para evaluar la privacidad de registros singulares.
La evaluación de estos problemas debe formar parte del diseño del proyecto.
En sistemas que afectan a personas, conviene incorporar controles de equidad y revisar los resultados antes de cualquier implementación.
Herramientas y recursos para generar datos sintéticos
Existen soluciones destinadas a diferentes tipos de información, desde datos tabulares hasta imágenes y secuencias temporales.
Entre las herramientas conocidas se encuentran bibliotecas de código abierto como Synthetic Data Vault (SDV), que permite trabajar con modelos de generación de datos estructurados, y Faker, utilizada principalmente para crear información ficticia mediante reglas y proveedores de valores.
También existen plataformas comerciales que ofrecen funcionalidades de generación, evaluación estadística y administración de conjuntos sintéticos.
La selección debe responder a las necesidades concretas del proyecto.
Una empresa que necesita crear nombres, direcciones ficticias y pedidos de prueba puede utilizar herramientas sencillas sin entrenar un modelo complejo.
En cambio, reproducir dependencias estadísticas entre numerosas variables puede exigir métodos especializados.
Antes de adoptar una solución, conviene comprobar su documentación, las condiciones de tratamiento de datos, la posibilidad de ejecutarla en entornos controlados y las opciones disponibles para evaluar privacidad y calidad.
La facilidad de uso no debe sustituir las verificaciones técnicas.
Cumplimiento normativo y protección de datos en proyectos de inteligencia artificial
La utilización de información sintética puede contribuir a minimizar el tratamiento de datos personales, pero no elimina automáticamente todas las obligaciones legales.
En la Unión Europea, el Reglamento General de Protección de Datos establece obligaciones cuando se procesan datos personales.
Si una organización utiliza información identificable para entrenar un generador, esa fase debe contar con una base jurídica apropiada y cumplir los principios aplicables.
El regulador británico ICO señala que los datos sintéticos que no pueden relacionarse con personas identificadas o identificables pueden quedar fuera del ámbito de la normativa de protección de datos personales. Sin embargo, también advierte que la generación puede requerir el tratamiento previo de información real sometida a obligaciones legales. <Cite ref="turn743025search0"/>
Por esta razón, las organizaciones deberían documentar la finalidad del procesamiento, las medidas de seguridad y los resultados de sus evaluaciones.
En proyectos sensibles puede ser necesario realizar una evaluación de impacto relativa a la protección de datos.
Además, deben considerarse las obligaciones sectoriales y las condiciones contractuales correspondientes.
Un conjunto sintético puede dejar de contener datos personales y seguir incluyendo información empresarial confidencial o material sujeto a otras restricciones.
Costes y beneficios de incorporar datos sintéticos en una empresa
La generación de información artificial puede reducir algunas dificultades asociadas a la obtención y utilización de datos, pero también implica costes.
La empresa debe invertir tiempo en preparar la información, elegir modelos adecuados, revisar resultados y mantener controles de seguridad.
Cuando se utilizan técnicas generativas complejas, pueden aparecer gastos adicionales de infraestructura y procesamiento.
Por ello, resulta conveniente evaluar el beneficio esperado antes de incorporar la tecnología.
Una empresa que necesita miles de perfiles ficticios para probar una aplicación probablemente obtenga resultados suficientes con un generador basado en reglas.
Entrenar un modelo avanzado para ese mismo propósito podría aumentar los costes sin proporcionar mejoras relevantes.
En cambio, cuando es necesario reproducir relaciones estadísticas complejas para desarrollar algoritmos predictivos, una inversión mayor puede estar justificada.
El análisis económico debería contemplar el ahorro de tiempo, la reducción de exposición de información, el rendimiento del sistema y los recursos necesarios para mantenerlo.
También debe considerar los costes derivados de errores, resultados sesgados o evaluaciones insuficientes.
Buenas prácticas para implementar datos sintéticos en inteligencia artificial
Una estrategia empresarial útil comienza con un caso de uso delimitado.
En lugar de generar grandes cantidades de información sin un propósito concreto, conviene identificar qué problema se desea resolver y qué propiedades necesita aprender el algoritmo.
Después, el equipo puede seleccionar una técnica proporcional a la complejidad de la tarea.
Es recomendable mantener un registro de las versiones del generador, los parámetros utilizados, los conjuntos de entrenamiento y los resultados de las evaluaciones.
Esto facilita detectar cambios inesperados y reproducir experimentos.
También es importante establecer criterios de aceptación antes de comenzar.
Por ejemplo, un conjunto puede considerarse suficientemente útil cuando cumple determinados requisitos de coherencia, reproduce las relaciones estadísticas consideradas esenciales y permite alcanzar un rendimiento predictivo previamente definido.
Los criterios de privacidad deben evaluarse por separado.
Si el conjunto no supera las pruebas de seguridad, no debería distribuirse solamente porque ofrece buenos resultados estadísticos.
Por último, las empresas deben establecer un procedimiento de revisión periódica, especialmente cuando cambian los productos, los clientes o los procesos que el sistema intenta representar.
El papel de los datos sintéticos en el futuro del aprendizaje automático
El desarrollo de modelos de inteligencia artificial más especializados ha incrementado el interés por fuentes de entrenamiento que puedan adaptarse a necesidades concretas.
Los datos sintéticos permiten construir escenarios artificiales, complementar conjuntos limitados y estudiar comportamientos que serían difíciles de observar directamente.
Su utilidad también se extiende al desarrollo de sistemas multimodales, donde pueden combinarse texto, imágenes, audio y otras modalidades de información.
La investigación continúa explorando métodos de generación que permitan controlar mejor las características de los ejemplos y evaluar con mayor precisión su utilidad.
Sin embargo, la disponibilidad de enormes cantidades de registros artificiales no garantiza modelos superiores.
La diversidad, el realismo funcional, la representatividad y la calidad de las evaluaciones siguen siendo factores determinantes.
Un sistema entrenado repetidamente con información sintética de baja calidad puede reforzar errores o perder contacto con la distribución de los datos reales.
Por eso, el desarrollo responsable requiere mantener procedimientos de validación independientes y supervisión técnica.
Para las organizaciones, la oportunidad principal consiste en utilizar esta tecnología allí donde aporte una ventaja demostrable: proteger información sensible, facilitar pruebas, ampliar escenarios de entrenamiento o reducir barreras de acceso a determinados datos. Los datos sintéticos para IA tienen mayor valor cuando se integran en una estrategia que combina calidad estadística, protección de la privacidad, control de sesgos y evaluación del rendimiento. Su adopción debe responder a necesidades concretas y verificables, con procedimientos que permitan demostrar tanto la utilidad de los modelos como el nivel de protección aplicado a la información original.




 Modalidad: Online

 Duración: 1500 horas

 Créditos: 60 ECTS


Déjanos tu comentario
Tu opinión nos ayuda a esforzarnos más para hacer programas con altos estándares de calidad que te ayuden a mejorar profesionalmente.